小米开源 MiMo-V2.6 登顶榜首?比起 46 分的狂欢,更值得看的是那 7000 个强化学习环境
小米开源 MiMo-V2.6 登顶榜首?比起 46 分的狂欢,更值得看的是那 7000 个强化学习环境
Wei Family LLC北京时间 9 月 22 日,小米正式发布并开源了 MiMo-V2.6 大模型系列。
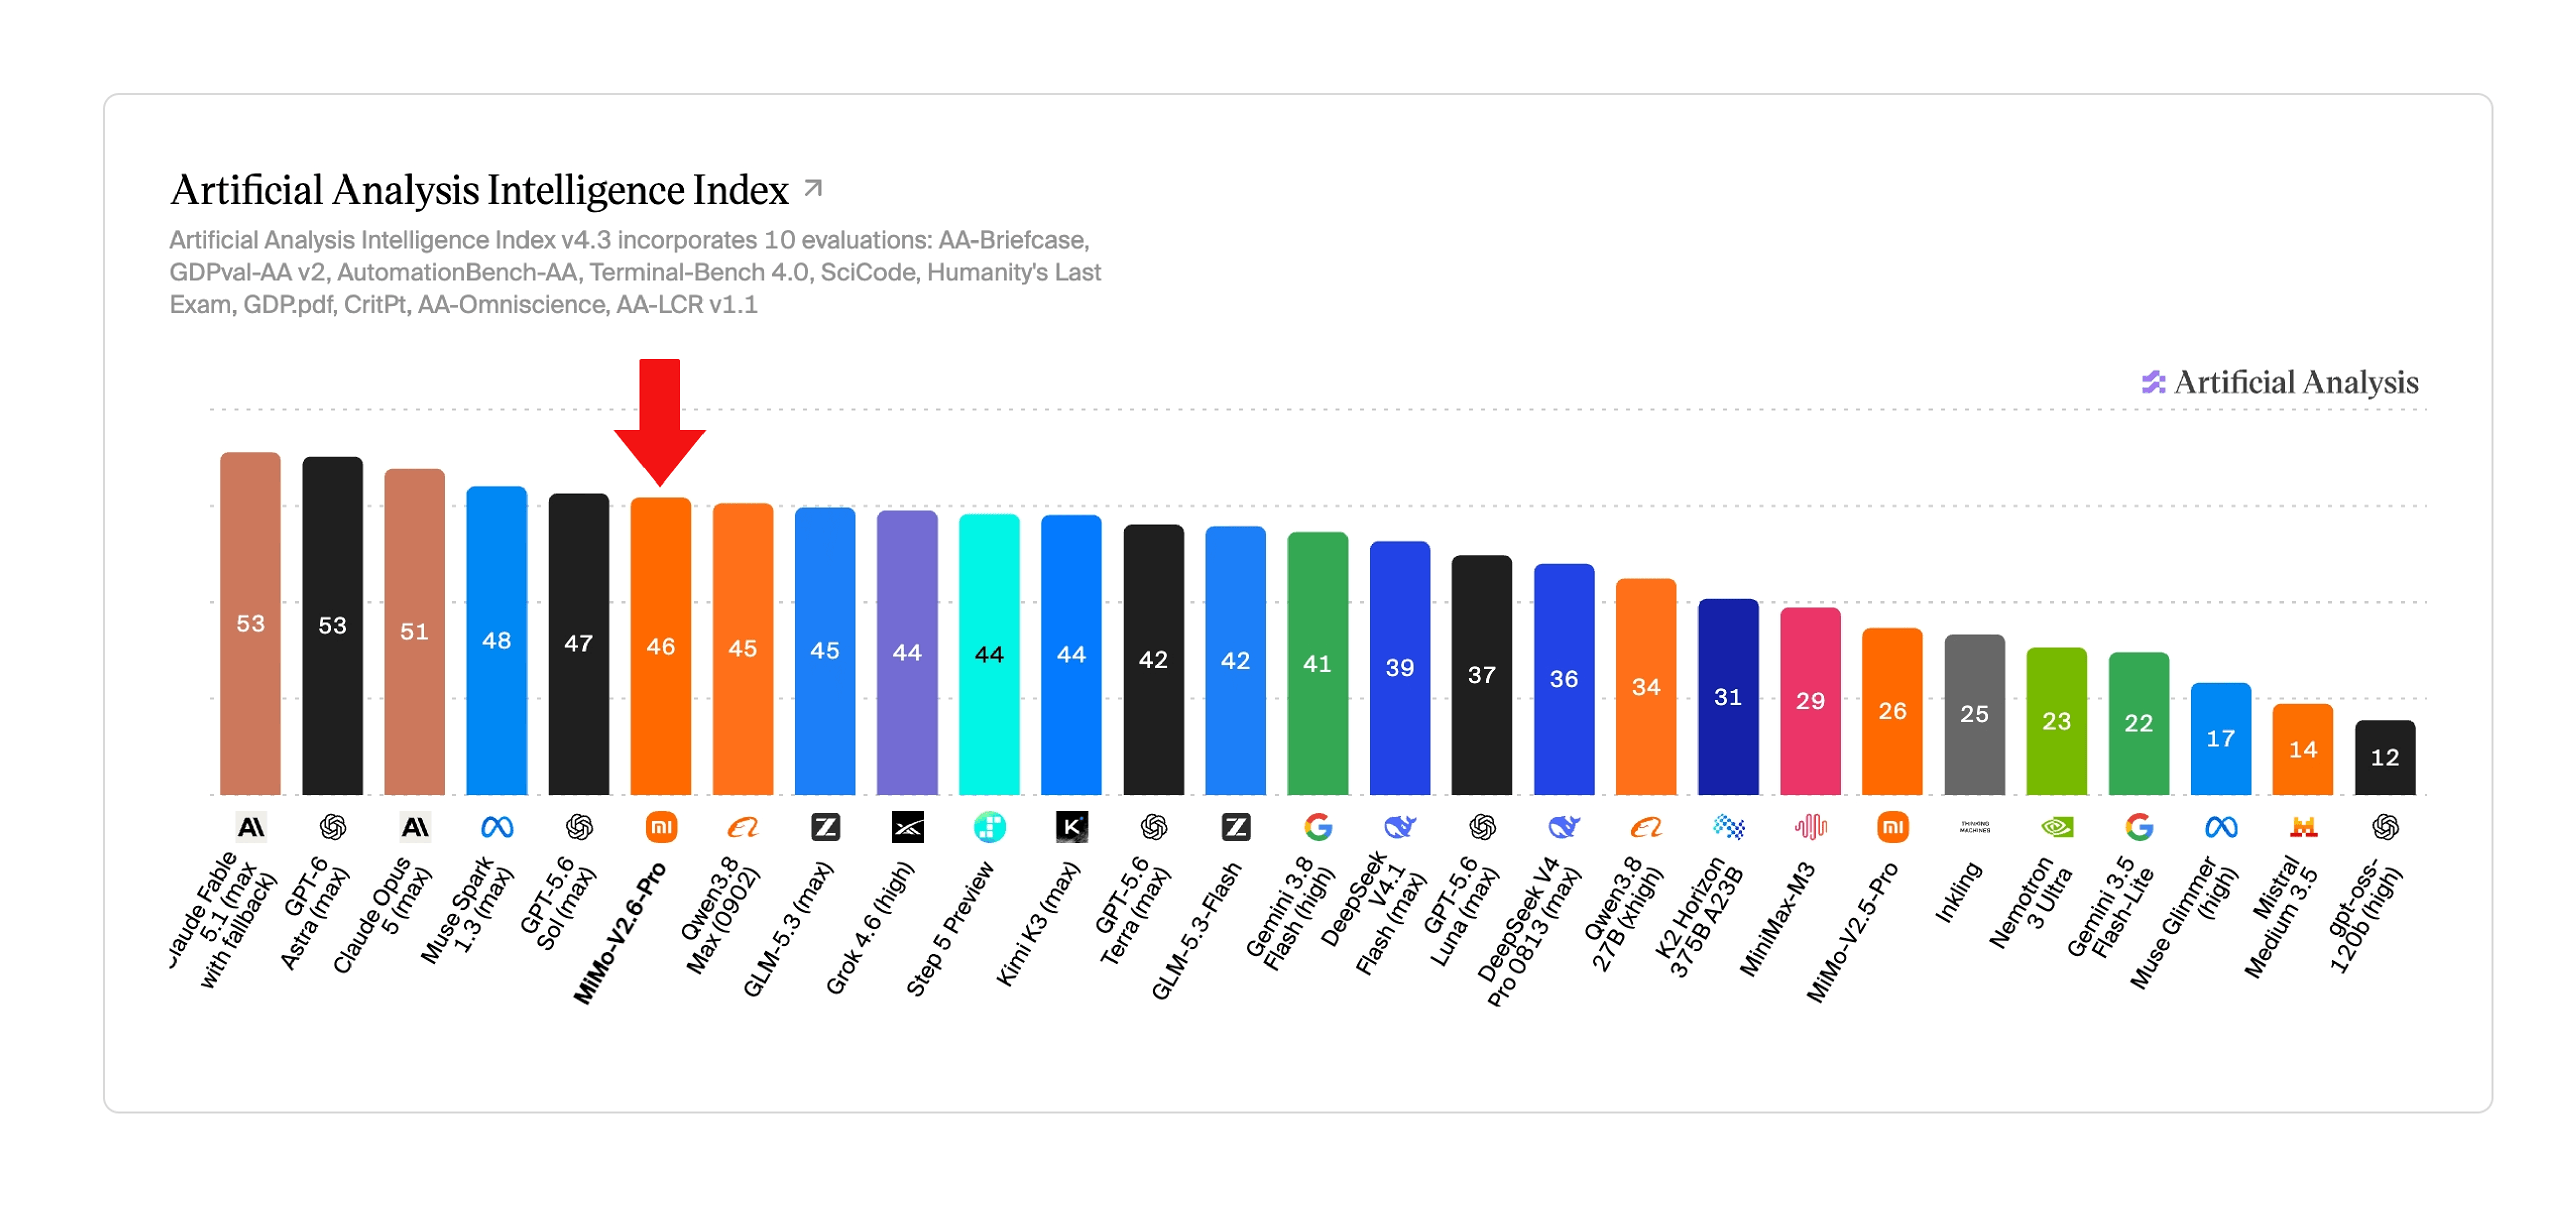
在第三方权威评测平台 Artificial Analysis(AA)公布的最新智能指数榜单上,旗舰模型 MiMo-V2.6-Pro 拿下了 46 分的高分,在同体量开源权重模型池中位居第一,宣称超越了此前的开源顶流 Kimi K3 与 Qwen3.8 Max。
社交媒体上瞬间被「小米大模型封神」、「雷军登顶全球开源榜」的口号刷屏。从手机、家电到智能汽车,小米每一次跨界总能引发巨大的舆论声量。
但作为一个理性的技术观察者,在铺天盖地的欢呼声中,我们需要先冷静下来剥离宣发水分,看清楚三个核心问题:这个「开源第一」到底有多少含金量?小米是怎么训出这台机器的?在 46 分背后,真正让行业震动的底牌究竟是什么?
先分清三层水位:哪些是客观事实,哪些是厂商口径?
围观大模型发布,最忌讳的是把官方 PPT 上的自测战报,直接当成既成事实。读懂 MiMo-V2.6,必须严格区分三层信息水位:
| 水位层级 | 核心内容 | 属性与客观性 |
|---|---|---|
| 第三方独立榜单 (Artificial Analysis) | MiMo-V2.6-Pro 智能指数为 46;在「开源权重、同体量档」对照池中位列 #1 / 114;上下文窗口 1M;总参数约 1.02T、激活参数约 42B;开源许可证为极为宽松的 MIT。 | 第三方独立可核验数据。代表其在 AA v4.3.2 综合测试集(涵盖 Coding、Agent、科学推理等)下的客观水准。 |
| 厂商官方宣称 (小米官方新闻稿) | 宣称 46 分「超越 Kimi K3 与 Qwen3.8 Max 成为最强开源」;多数 Agent 基准「对标 Claude Opus 5、GPT-5.6 Sol」;同智能水平下推理成本「仅为海外的 1/20~1/60」。 | 厂商官方立场。对比基准与成本倍数多为实验室特定场景估算,属宣发口径。 |
| 可下载交付物 (Hugging Face / GitHub) | 开源权重仓库 XiaomiMiMo/mimo-v26:包括 Pro-RL、Flash-RL、Distill-Qwen-9B;公开技术报告、训练框架源码及 7000+ 强化学习任务环境。 |
社区可复现产物。代码与权重真实可查,但实际跑分仍取决于部署与微调水平。 |
值得肯定的是,小米在官方战报里并没有盲目自大——在宣称开源领先的同时,官方主动写明了与全球闭源霸主 Claude Fable 5.1 以及 GPT-6 Astra 之间依然存在明显代差。这种坦诚,在当下浮躁的模型公关战中显得尤为难得。
架构与训练账本:6 天烧掉 262 万美元的“实时强化学习”
很多人以为 MiMo-V2.6 又是靠死堆预训练语料刷出来的,但翻看技术报告就会发现,小米这次的核心技术叙事已经彻底转向:押注 RSI(递归自我改进,Recursive Self-Improvement)路径,全面放大强化学习(RL)的算力杠杆。
1. 动静结合的模型架构
- MiMo-V2.6-Pro-RL(旗舰):稀疏 MoE 架构,总参数约 1.02T,单次推理仅激活约 42B。原生支持文本、图像、音频、视频全模态输入,原生支持 1M 超长上下文。
- MiMo-V2.6-Flash-RL(高能效档):针对生产部署优化,总参数 309B,激活仅 15B,主打极低延迟与高性价比。
- MiMo-V2.6-Distill-Qwen-9B:针对端侧与开发者轻量化场景的蒸馏小模型。
2. 令人瞩目的 Live RL 训练账单
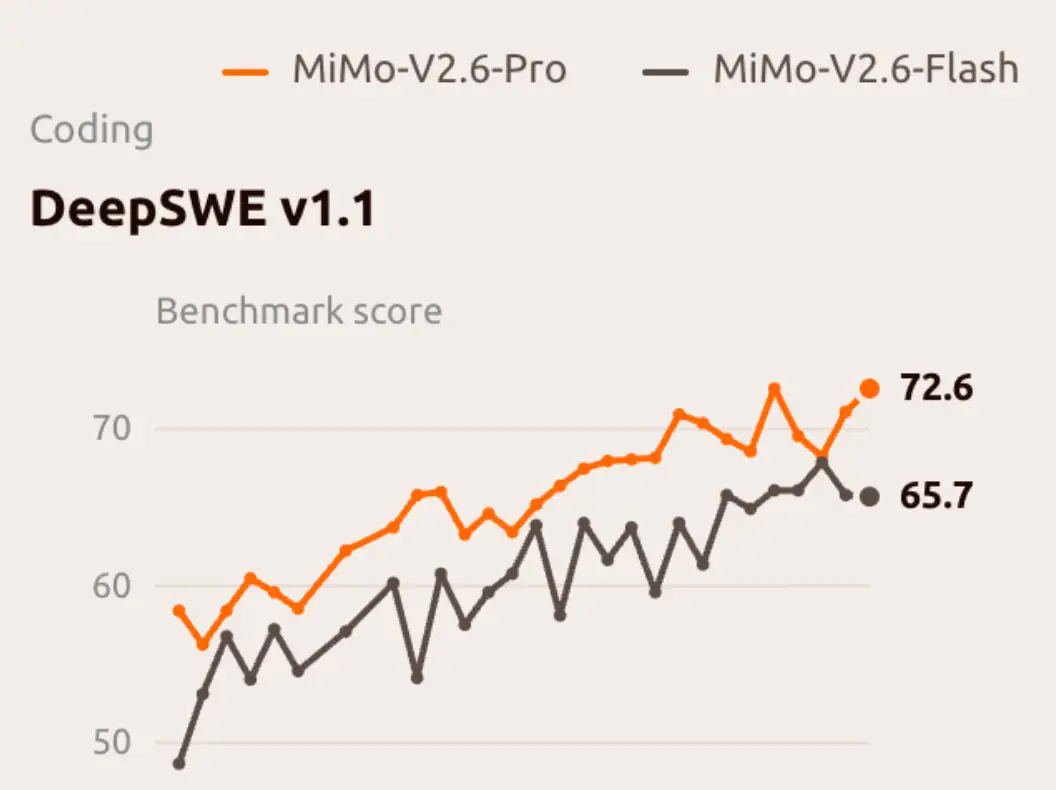
官方罕见地公布了本轮强化学习演进的真实工程账本(Pro 与 Flash 各迭代 30 步,累计消耗约 75 万条探索轨迹):
- 真实训练成本:Flash 档花费约 85 万美元,Pro 档花费约 262 万美元;
- 真实能力跃迁:在最具实战检验力度的长程软件工程榜单 DeepSWE v1.1 上,Flash 从 48.8 跃升至 65.7(+17),Pro 从 58.4 飙升至 72.6(+14);
- 极致吞吐工程:单步处理约 1568 个长难样本、单步吞吐高达 3.5~3.7B tokens。为了防止模型在海量自我探索中“学坏”,团队采用了冻结 Router、设置组内相对奖励评分、构建 Reward Hacking 防护网等一系列高难度工程措施。
这组数字向行业释放了一个明确信号:大模型能力的质变期,正在从“海量无监督预训练”迅速转向“大规模高难度可验证环境下的强化学习探索”。
为什么说 7000+ RL 环境比权重本身更值钱?
过去两年,很多大厂所谓的“开源”,实际上是“甩卖式开源”——开发者在 Hugging Face 上只能领到一个动辄几百 G 的打包权重(Weight Dump)。模型怎么做 RL 的?奖励模型怎么打分的?训练环境长什么样?全被锁在保险柜里。开发者只能用它做简单推理,想深入研究或针对性迭代几乎无从下手。
而小米这次最大的功绩,在于它打破了这种「伪开源」壁垒,把整套后训练生态推到了阳光下:
- 7,000+ 高质量强化学习环境开源:覆盖真实软件工程(Issue 复现与修复)、安全漏洞渗透测试、复杂前端设计与开发、科研形式化证明等高价值领域;
- 端到端基础设施全盘公开:开放基于 verl、uni-agent 和 mini-swe-agent 构建的完整训练框架;
- 轻量级评估套件 mini-harness:让中小企业和高校实验室无需从零造轮子,就能直接复现大规模强化学习训练流程。
这就好比别家只是送了你一辆调校好的成品赛车,而小米不仅把赛车钥匙交出来,还把生产流水线图纸、风洞测试标准和 7000 条专业赛道一口气全打包送给了开源社区。
再加上完全允许商业化自托管的 MIT 许可证,对于苦于没有高质量强化学习训练环境的广大科研机构与工程团队来说,这份资料的价值远超单次跑分的高低。
商业与生态算盘:极致性价比与「人车家全生态」闭环
秀肌肉的终点必然是商业变现与生态落地。小米在产品化上的布局同样极其务实:
- 加量不加价的 API 定价:V2.6 系列在性能大幅飞跃的前提下,官方 API 定价完全维持 V2.5 原价。根据 AA 平台的监控口径,其输入输出参考价仅为 $0.435 / $0.87 每百万 tokens,几乎是海外对标模型价格的几十分之一;
- UltraSpeed 推理加速:面向开发者和企业客户推出专用推理加速方案,官方宣称最高可达 20 倍延迟优化;
- 全场景具身与智能协同:在官方演示中,从 3D 游戏协作、Blender 自动化建模,到 Franka 机械臂的物理仿真与 Computer Use,无一不在对齐小米自身的「人车家全生态」战略。
对于小米而言,大模型不是飘在云端的炫技玩具,它是为数亿部智能手机、数十万辆智能汽车、海量 IoT 设备乃至未来的具身智能机器人准备的统一底座大脑。
跑分会被超越,开源的诚意才会被铭记
在 AI 领域,没有永远的「第一」。今天的 46 分明天就可能被友商刷新,榜单的排位永远取决于评测版本、对照池范围和时间节点。
但 MiMo-V2.6 的意义在于:它证明了中国科技巨头不仅能在消费硬件上做到极致,同样有能力在大模型最硬核的强化学习与系统工程领域打出漂亮的一击;更难得的是,在闭源防守日趋严重的今天,小米依然选择用最纯粹的 MIT 协议,把完整的技术报告、训练框架与数千个复杂环境奉献给全球开发者。
热度退去之后,1T 级别的 MoE 权重究竟有多少团队能够低成本部署?在企业极其复杂的非标准化场景中,模型的 Agent 能力是否真如自测般稳健?这些才是留在社区面前的真正考卷。
但无论如何,这场属于开源社区的盛宴,已经实实在在地开始了。